我们从一个实际业务场景的谈起:
如何找到离北京市海淀区 768 创意产业园最近的 K 个国家级观测站?
最简单的思路是完整遍历所有候选站点,然后计算每个站点和 768 的距离,按照距离从小到大,选最多前 K 个。 这个代码并不难写。但是问题是慢。
为什么性能会成为问题呢?原因是在我们的实际业务中,距离的计算是不能直接用二维平面距离 $\sqrt{(x_{1} - x_{2})^2 + (y_{1} - y_{2})^2} $ 直接替代的,原因是地球是个曲面,当相对距离变得足够大的时候,地球的曲率就会影响地球表面点之间的距离。
计算距离最准的公示叫 Vincenty’s formulae 它的计算方式非常复杂,有大量的三角函数运算:
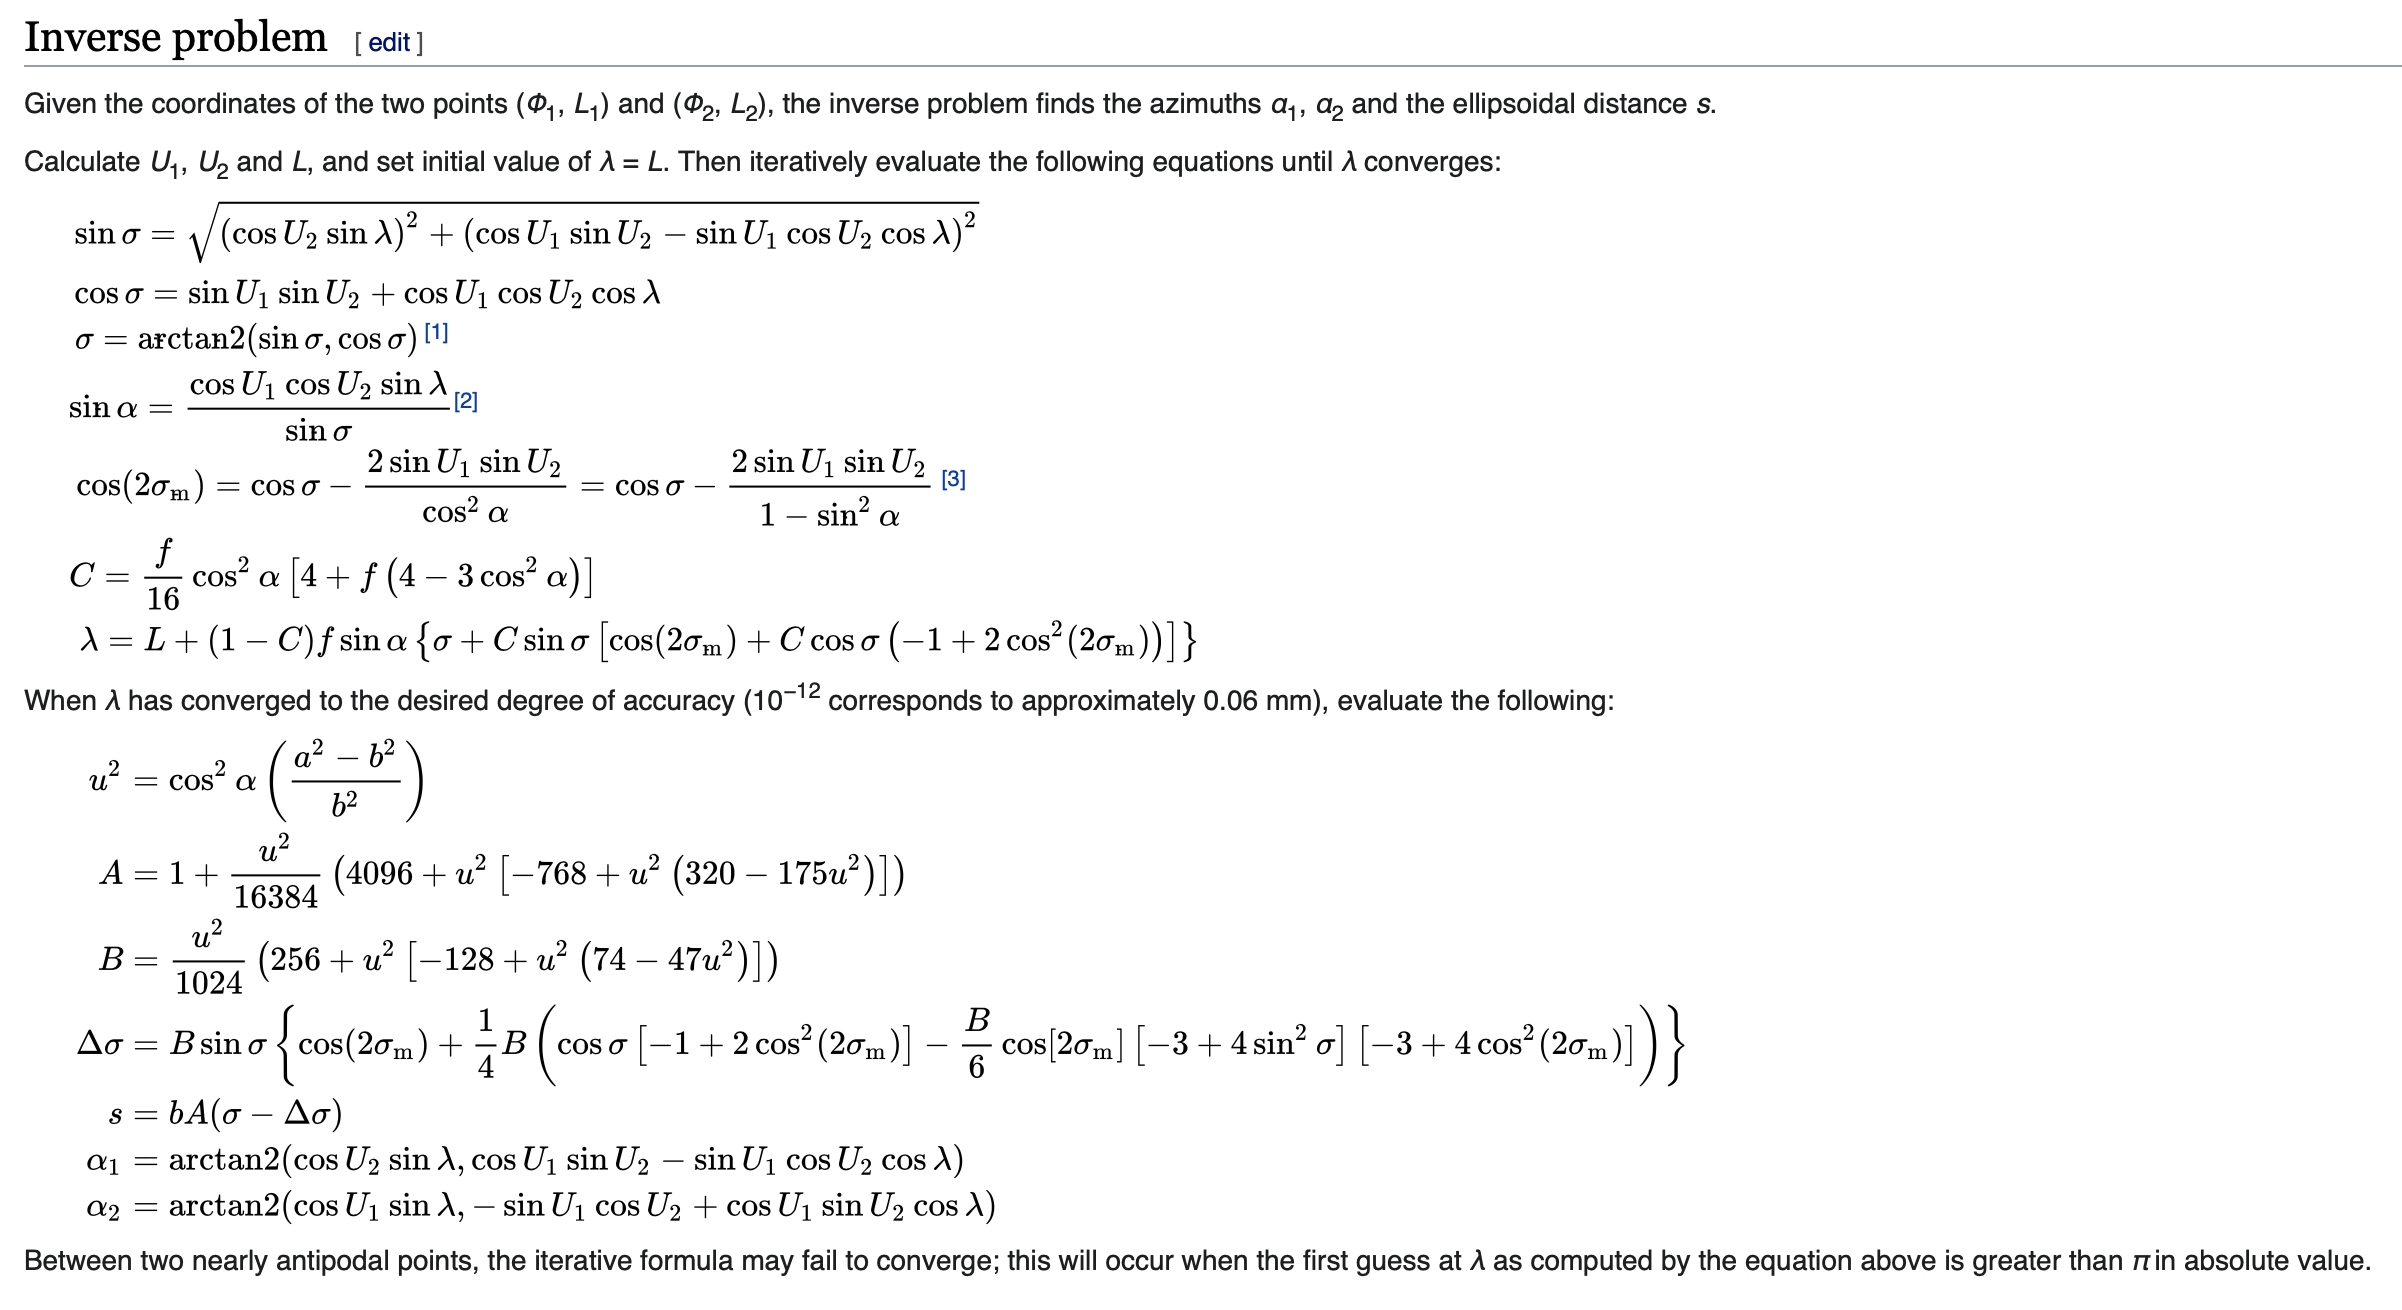
另一个替代品则是半正矢公式:
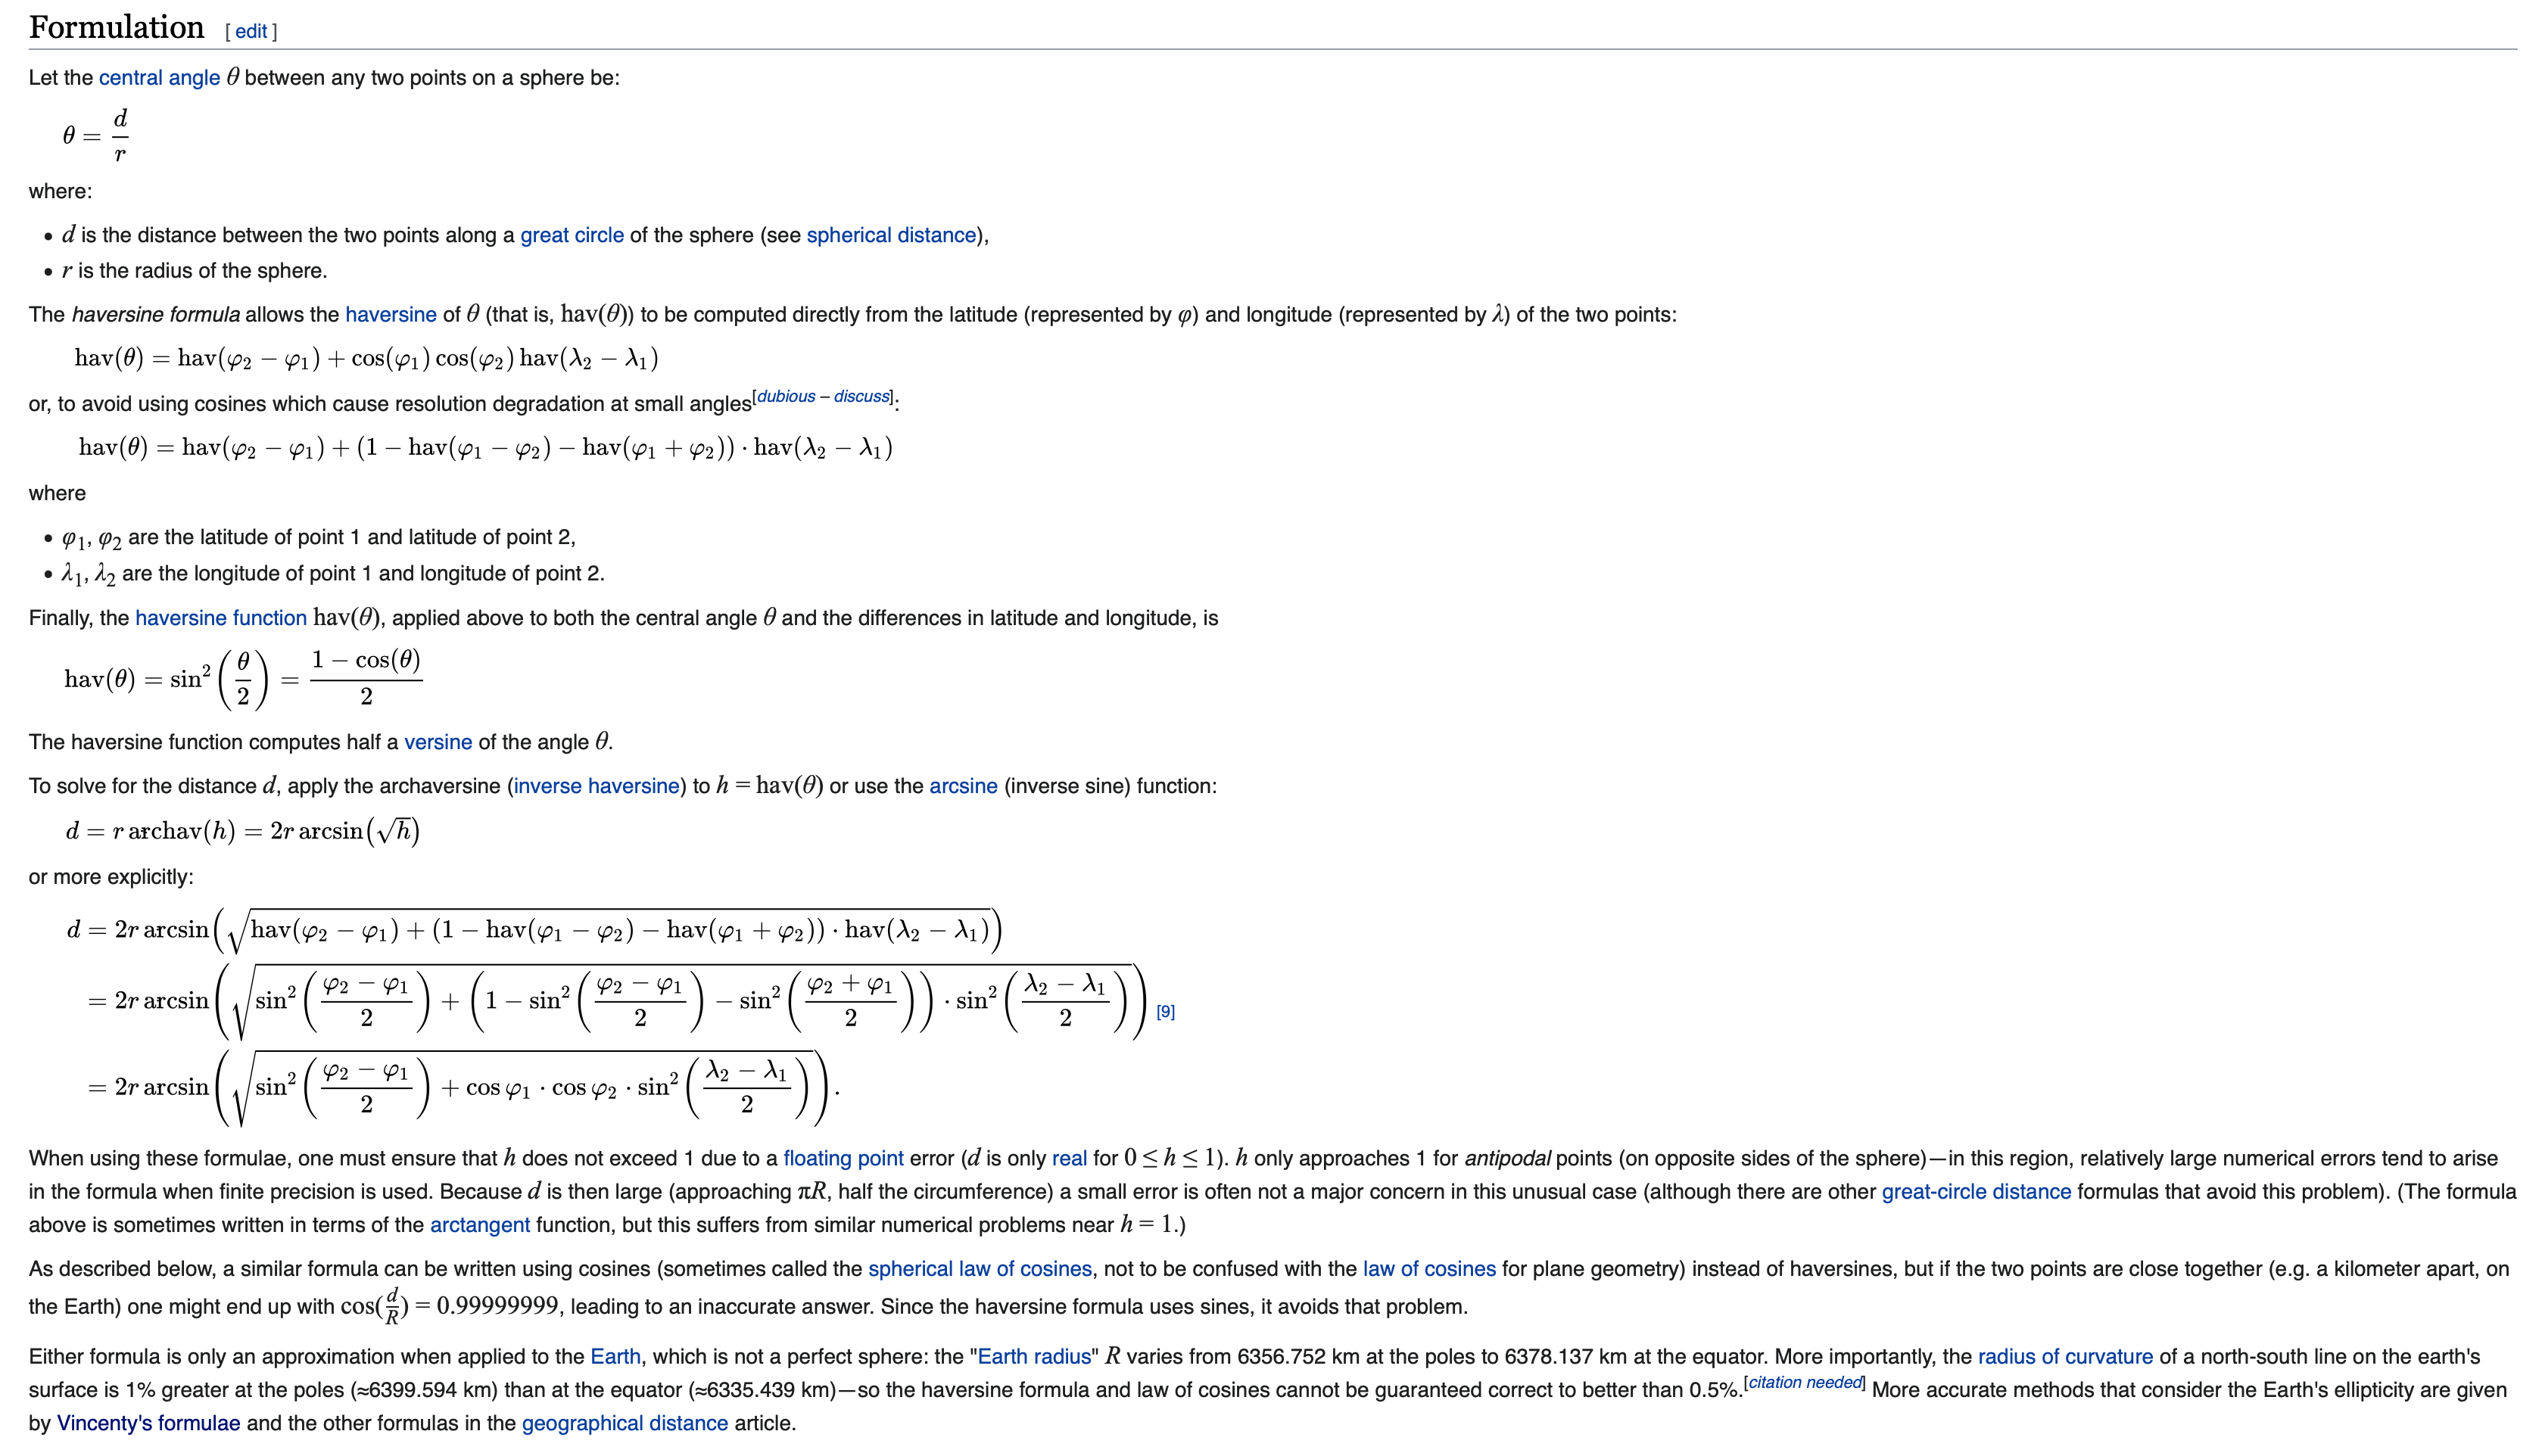
准确率差一些,但是对于气象数据而言空间精度是足够的了。但问题是这个公式内部还是有多处三角函数运算,虽然在 CPU 上都有了指令级别的计算优化,但是三角函数的运算相对于加减乘除而言性能整体上还是比较慢的。在候选站点数据量成千上万的时候会带来可观的 CPU 开销。
我们采用的第一个优化是对经纬度范围做了粗略的控制, 只有符合一定 bounding box 的坐标才会进行半正矢距离计算,否则就跳过。 经过这个优化一般的站点获取并排序需要 20,0000 ns 个别慢的查询需要 40,0000 ns。
这个速度对 Go 这个静态语言而言是有些慢的,我们期望能尽可能降低这部分开销,因为峰值的时候一秒要进行数万次这类操作,速度上的优化对于控制成本而言也是有帮助的。于是我们对程序的运行做了 pprof 发现真正消耗 CPU 的部分是内存分配上,原因是我们用了一个 for 循环遍历一个长度上万的 slice 引起了一定的内存分配开销。所以优化的核心任务是避免遍历全部数据,需要一个地理索引机制来提高效率。
我们调研了一下社区的各种 RTree/QuadTree 实现,结果部分场景还是有性能问题,比如部分数据查询耗时在 10,0000 ns 左右,而且 KNN 实现没有做排序处理,实际上还是要自行计算距离并排序。于是决定「闭门造车」,用一种理解起来更方便,并且足够快的方式实现。 不过喜欢用 RTree 的同学不用着急,RTree 会在后两节相遇。
思路上受到了地图瓦片的启发,我们可以计算每个站点属于地图上特定缩放等级下哪个瓦片索引(x,y)上的数据。并且可以通过在 x,y 索引上执行 ±1/0 的操作得到周围一圈的 8 个瓦片索引值:
| |
得益于瓦片的索引结构,除了最开始的瓦片设计了三角函数运算以外,就只是加减法运算了。
为了方便起见,内部在 map 中用倒序的 z,y,x 顺序存储站点所在的瓦片索引,这样在筛选的时候不用暴力遍历所有站点,而只是查 9 个 key。
目前的我们获取到的观测站数据,除了美国本土的分布是比较均匀的以外,其他国家地区站点的空间分布是非常不均匀的,比如中国中东部密度比中国西部要大,西欧的站点密度比东欧的密度大,所以在实际业务中我们采用了双层预索引机制,当高分辨率瓦片获取不到数据的时候就降级到更粗糙的尺度上做搜索。
经过这个优化我们的站点查询耗时只需要 900ns 至 3000ns 左右,服务的 CPU 开销降低了 10%。 在计划中,也有基于 RTree 索引选项,对于一些空间分辨率不固定的稀疏数据会默认用 RTree 覆盖,实现自适应调整。